Python 垃圾回收:引用计数、分代回收与缓存机制
学习目标:理解 CPython 如何自动管理内存——引用计数器为主,标记清除和分代回收为辅,辅以缓存机制提升效率。
1 整体架构
CPython 的垃圾回收由三层机制协同工作:
| 机制 | 解决的问题 | 触发方式 |
|---|---|---|
| 引用计数 | 及时回收无循环引用的对象 | 实时(引用+1/-1时) |
| 标记清除 + 分代回收 | 解决循环引用问题 | 达到阈值时触发 |
| 缓存机制 | 减少反复创建/销毁的开销 | 对象销毁时自动缓存 |
2 引用计数器
2.1 refchain:全局对象链表
Python 程序中所有对象都被添加到一个名为 refchain 的环状双向链表中。
age = 18
name = "武沛齐"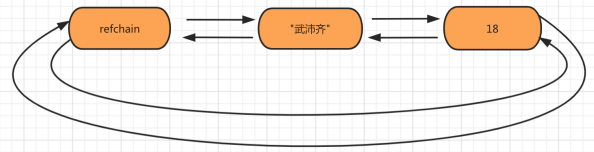
2.2 ob_refcnt:引用计数器
refchain 中的每个对象内部都有一个 ob_refcnt 字段,记录自己被引用的次数。
age = 18
name = "武沛齐"
nickname = name  # name 对象的引用计数 +1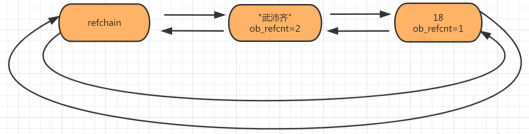
引用计数变化规则:
age = 18
number = age          # 对象 18 的引用计数 +1
del age               # 对象 18 的引用计数 -1

def run(arg):
    print(arg)
run(number)           # 函数执行时 +1,执行完毕 -1

num_list = [11, 22, number]  # 对象 18 的引用计数 +1
当 ob_refcnt 变为 0 时,对象从 refchain 中摘除并销毁(暂不考虑缓存)。
3 标记清除与分代回收
3.1 循环引用问题
引用计数无法处理循环引用:
v1 = [11, 22, 33]   # 引用计数 = 1
v2 = [44, 55, 66]   # 引用计数 = 1
v1.append(v2)        # v2 引用计数 = 2
v2.append(v1)        # v1 引用计数 = 2
del v1               # v1 引用计数 = 1(不为 0,无法销毁)
del v2               # v2 引用计数 = 1(不为 0,无法销毁)
# 两个列表永远无法被引用计数回收 → 内存泄漏
3.2 标记清除
为解决循环引用,CPython 维护一个额外链表,专门存放可能存在循环引用的对象(list、tuple、dict、set、自定义类等可嵌套类型)。
扫描时发现循环引用 → 双方引用计数各 -1 → 引用计数归零的对象被销毁。
3.3 分代回收
将可能存在循环引用的对象拆分到 3 个链表(0/1/2 代),按生命周期分级管理:
// 分代回收的 C 源码定义
#define NUM_GENERATIONS 3
struct gc_generation generations[NUM_GENERATIONS] = {
    /* PyGC_Head,                threshold, count */
    {{(uintptr_t)_GEN_HEAD(0), (uintptr_t)_GEN_HEAD(0)}, 700, 0},  // 0 代
    {{(uintptr_t)_GEN_HEAD(1), (uintptr_t)_GEN_HEAD(1)}, 10,  0},  // 1 代
    {{(uintptr_t)_GEN_HEAD(2), (uintptr_t)_GEN_HEAD(2)}, 10,  0},  // 2 代
};各代含义:
| 代 | count 含义 | threshold 含义 | 触发条件 |
|---|---|---|---|
| 0 代 | 0 代链表中的对象数量 | 对象数量阈值(700) | 新对象数 > 700 |
| 1 代 | 0 代链表被扫描的次数 | 扫描次数阈值(10) | 0 代扫描 > 10 次 |
| 2 代 | 1 代链表被扫描的次数 | 扫描次数阈值(10) | 1 代扫描 > 10 次 |
扫描逻辑(当 0 代超过阈值时):
- 先检查 2 代、1 代是否也超过阈值
- 若 2、1 代未超 → 只扫描 0 代,1 代 count +1
- 若 1 代超过 → 拼接 1 代 + 0 代一起扫描,count 重置为 0
- 若 2 代超过 → 拼接 2 + 1 + 0 三代全扫描,count 全部重置为 0
3.4 情景模拟
第一步:创建 age = 19,添加到 refchain
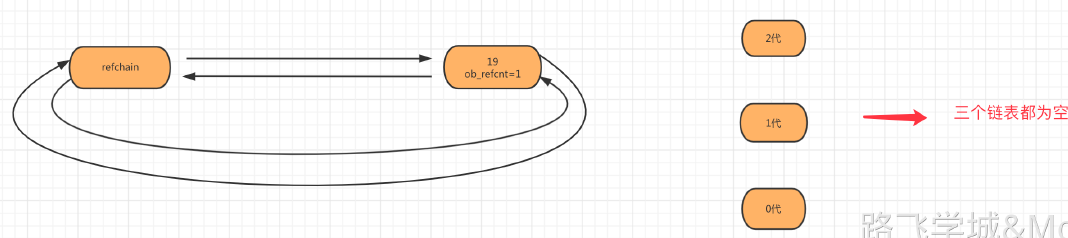
第二步:创建 num_list = [11, 22],同时添加到 refchain 和 0 代链表
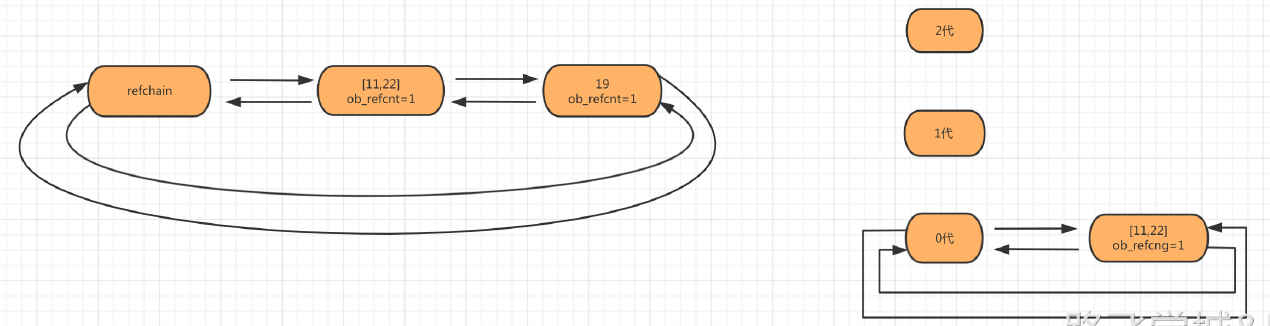
第三步:0 代对象数超过阈值 700 时,触发扫描
扫描过程(对拼接后的链表):
- 拷贝引用计数:将每个对象的
ob_refcnt拷贝到gc_refs,保护原值 - 检测循环引用:扫描链表,发现循环引用则让
gc_refs各 -1 - 分类处理:
gc_refs == 0→ 移入unreachable链表(不可达)gc_refs != 0→ 升级到下一代链表
- 处理
unreachable:- 有
__del__方法的对象 → 放入finalizers链表,执行析构后再销毁 - 有弱引用的对象 → 处理弱引用回调
- 仍不可销毁的 → 升级到下一代
- 有
- 销毁:将
unreachable中的对象销毁并从refchain移除
4 缓存机制
反复创建和销毁对象会降低执行效率。CPython 引入缓存机制:引用计数为 0 时,不立即销毁对象,而是放入 free_list 缓存;下次创建同类型对象时优先从缓存取用。
4.1 各类型的缓存策略
| 类型 | 缓存池 | 缓存容量 |
|---|---|---|
| float | free_list | 最多 100 个对象 |
| int | small_ints(小数据池) | -5 ≤ value < 257 |
| str | unicode_latin1[256] | 所有 ASCII 字符 + 驻留机制 |
| list | free_list | 最多 80 个对象 |
| tuple | free_list(按元素个数分组) | 容量 20 的数组,每组最多 2000 个 |
| dict | free_list | 最多 80 个对象 |
4.2 float 缓存示例
v1 = 3.14
print(id(v1))   # 4436033488
del v1           # 引用计数归零 → 不销毁,放入 free_list

v2 = 9.999
print(id(v2))   # 4436033488(复用了 v1 的内存地址)
4.3 int 小数据池
v1 = 38
print(id(v1))   # 4514343712
v2 = 38
print(id(v2))   # 4514343712(同一对象,从小数据池获取)

# 注意:-5~256 在解释器启动时就已加入 small_ints,引用计数初始化为 1,永不销毁
4.4 str 驻留机制
# ASCII 字符缓存
v1 = "A"
print(id(v1))   # 4517720496
del v1
v2 = "A"
print(id(v2))   # 4517720496(从 unicode_latin1 缓存获取)

# 驻留机制:仅含字母、数字、下划线的字符串会被驻留
v1 = "wupeiqi"
v2 = "wupeiqi"
print(id(v1) == id(v2))  # True(内存中只有一份)
4.5 list / tuple / dict 缓存
# list:free_list 最多缓存 80 个
v1 = [11, 22, 33]
print(id(v1))   # 4517628816
del v1
v2 = ["武", "沛齐"]
print(id(v2))   # 4517628816(复用地址)

# tuple:按元素个数分组缓存
v1 = (1, 2)
del v1           # 缓存到 free_list[2] 链表中
v2 = ("武沛齐", "Alex")  # 从 free_list[2] 获取

# dict:free_list 最多缓存 80 个
v1 = {"k1": 123}
del v1
v2 = {"name": "武沛齐", "age": 18}
5 C 源码分析
以下分析基于 CPython 源码,展示各类型对象的创建、引用、销毁的底层实现。
5.1 核心结构体
所有 Python 对象的基石——PyObject 和 PyVarObject:
// 宏定义:用于构造双向链表(refchain 中使用)
#define _PyObject_HEAD_EXTRA \
    struct _object *_ob_next; \
    struct _object *_ob_prev;

typedef struct _object {
    _PyObject_HEAD_EXTRA      // 双向链表指针
    Py_ssize_t ob_refcnt;     // 引用计数器
    struct _typeobject *ob_type; // 数据类型
} PyObject;

typedef struct {
    PyObject ob_base;         // 继承 PyObject
    Py_ssize_t ob_size;       // 可变长度部分的元素个数
} PyVarObject;- PyObject:所有对象共有的 4 个字段(前后指针 + 引用计数 + 类型)
- PyVarObject:在 PyObject 基础上增加
ob_size(list、tuple 等容器使用)
5.2 常见类型的结构体
// float
typedef struct {
    PyObject_HEAD
    double ob_fval;
} PyFloatObject;

// int
struct _longobject {
    PyObject_VAR_HEAD
    digit ob_digit[1];
};
typedef struct _longobject PyLongObject;

// list
typedef struct {
    PyObject_VAR_HEAD
    PyObject **ob_item;
    Py_ssize_t allocated;
} PyListObject;

// tuple
typedef struct {
    PyObject_VAR_HEAD
    PyObject *ob_item[1];
} PyTupleObject;

// dict
typedef struct {
    PyObject_HEAD
    Py_ssize_t ma_used;
    PyDictKeysObject *ma_keys;
    PyObject **ma_values;
} PyDictObject;
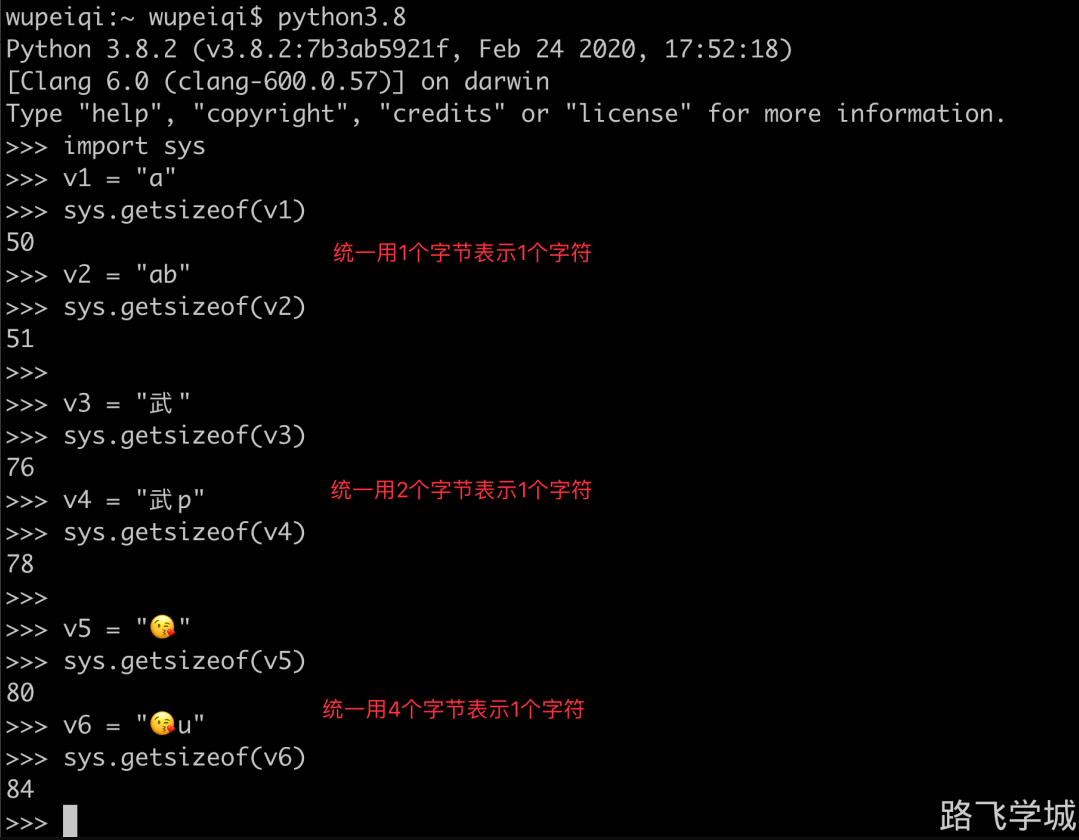
str 类型较复杂:需考虑编码问题——ASCII 用 1 字节(latin1),中文用 2 字节(ucs2),emoji 用 4 字节(ucs4)。
5.3 Float 类型生命周期
创建
val = 3.14// Objects/floatobject.c
static PyFloatObject *free_list = NULL;
static int numfree = 0;
PyObject * PyFloat_FromDouble(double fval) {
PyFloatObject *op = free_list;
if (op != NULL) {
// 从 free_list 取出缓存对象
free_list = (PyFloatObject *) Py_TYPE(op);
numfree--;
} else {
// 缓存为空,新开辟内存
op = (PyFloatObject*) PyObject_MALLOC(sizeof(PyFloatObject));
if (!op) return PyErr_NoMemory();
}
// 初始化:引用计数=1,添加到 refchain
(void)PyObject_INIT(op, &PyFloat_Type);
op->ob_fval = fval;
return (PyObject *) op;
}引用
val = 3.14
data = val # 引用计数 +1// Include/object.h
static inline void _Py_INCREF(PyObject *op) {
_Py_INC_REFTOTAL;
op->ob_refcnt++; // 引用计数 +1
}销毁
val = 3.14
del val # 引用计数 -1,归零则缓存或销毁// Include/object.h
static inline void _Py_DECREF(const char *filename, int lineno, PyObject *op) {
_Py_DEC_REFTOTAL;
if (--op->ob_refcnt != 0) {
// 引用计数不为 0,继续
} else {
_Py_Dealloc(op); // 引用计数为 0,执行销毁
}
}
// Objects/floatobject.c — float 的 tp_dealloc
#define PyFloat_MAXFREELIST 100
static void float_dealloc(PyFloatObject *op) {
if (PyFloat_CheckExact(op)) {
if (numfree >= PyFloat_MAXFREELIST) {
PyObject_FREE(op); // 缓存已满,直接销毁
return;
}
// 加入 free_list 缓存
numfree++;
Py_TYPE(op) = (struct _typeobject *)free_list;
free_list = op;
} else {
Py_TYPE(op)->tp_free((PyObject *)op);
}
}5.4 Int 类型生命周期
创建
age = 19// Objects/longobject.c
PyObject * PyLong_FromLong(long ival) {
PyLongObject *v;
// 优先检查小数据池(-5 <= value < 257)
CHECK_SMALL_INT(ival);
// 不在小数据池中,新开辟内存
v = _PyLong_New(ndigits);
if (v != NULL) {
digit *p = v->ob_digit;
Py_SIZE(v) = ndigits * sign;
t = abs_ival;
}
return (PyObject *)v;
}
#define NSMALLNEGINTS 5
#define NSMALLPOSINTS 257
#define CHECK_SMALL_INT(ival) \
do if (-NSMALLNEGINTS <= ival && ival < NSMALLPOSINTS) { \
return get_small_int((sdigit)ival); \
} while(0)销毁
int 类型基于小数据池而非 free_list 缓存,引用计数归零时直接销毁(不缓存)。
// Objects/longobject.c
PyTypeObject PyLong_Type = {
    ...
    0,               /* tp_dealloc — 未定义,继承父类 */
    ...
    PyObject_Del,    /* tp_free */
};

// 父类 object 的 tp_dealloc
static void object_dealloc(PyObject *self) {
    Py_TYPE(self)->tp_free(self);  // 调用 PyObject_Del 销毁
}
5.5 Str 类型生命周期
创建
name = "武沛齐"// Objects/unicodeobject.c
static PyObject * unicode_decode_utf8(...) {
// 单个 ASCII 字符 → 直接从缓存获取
if (size == 1 && (unsigned char)s[0] < 128) {
return get_latin1_char((unsigned char)s[0]);
}
// 其他情况 → 按编码转换(latin1/ucs2/ucs4)
return _PyUnicodeWriter_Finish(&writer);
}驻留机制:将字符串保存到 interned 字典中,后续使用时直接从字典获取。实际上是每次创建新字符串后检查是否已驻留,若已驻留则复用旧的、销毁新的。
// Objects/unicodeobject.c
void PyUnicode_InternInPlace(PyObject **p) {
    PyObject *s = *p;
    ...
    // 尝试驻留到 interned 字典
    t = PyDict_SetDefault(interned, s, s);
    if (t != s) {
        // 已存在 → 复用旧字符串,引用计数 +1
        Py_INCREF(t);
        Py_SETREF(*p, t);
        return;
    }
    // 新驻留 → 减少 2 个引用计数(interned 字典的两个引用不计入 refcnt)
    Py_REFCNT(s) -= 2;
    _PyUnicode_STATE(s).interned = SSTATE_INTERNED_MORTAL;
}
销毁
// Objects/unicodeobject.c
static void unicode_dealloc(PyObject *unicode) {
    switch (PyUnicode_CHECK_INTERNED(unicode)) {
    case SSTATE_NOT_INTERNED:
        break;
    case SSTATE_INTERNED_MORTAL:
        // 从 interned 字典中删除
        Py_REFCNT(unicode) = 3;  // 临时复活
        PyDict_DelItem(interned, unicode);
        break;
    case SSTATE_INTERNED_IMMORTAL:
        Py_FatalError("Immortal interned string died.");
    }
    // 释放各编码的内存
    if (_PyUnicode_HAS_WSTR_MEMORY(unicode))
        PyObject_DEL(_PyUnicode_WSTR(unicode));
    if (_PyUnicode_HAS_UTF8_MEMORY(unicode))
        PyObject_DEL(_PyUnicode_UTF8(unicode));
    if (!PyUnicode_IS_COMPACT(unicode) && _PyUnicode_DATA_ANY(unicode))
        PyObject_DEL(_PyUnicode_DATA_ANY(unicode));
    Py_TYPE(unicode)->tp_free(unicode);
}
5.6 List 类型生命周期
创建
v = [11, 22, 33]// Objects/listobject.c
#define PyList_MAXFREELIST 80
static PyListObject *free_list[PyList_MAXFREELIST];
static int numfree = 0;
PyObject * PyList_New(Py_ssize_t size) {
PyListObject *op;
if (numfree) {
// 从 free_list 获取缓存对象
numfree--;
op = free_list[numfree];
_Py_NewReference((PyObject *)op);
} else {
// 缓存为空,新开辟内存(含 GC 头部)
op = PyObject_GC_New(PyListObject, &PyList_Type);
if (op == NULL) return NULL;
}
// 分配元素存储空间
if (size <= 0)
op->ob_item = NULL;
else {
op->ob_item = (PyObject **) PyMem_Calloc(size, sizeof(PyObject *));
if (op->ob_item == NULL) {
Py_DECREF(op);
return PyErr_NoMemory();
}
}
Py_SIZE(op) = size;
op->allocated = size;
// 加入分代回收的 0 代链表
_PyObject_GC_TRACK(op);
return (PyObject *) op;
}list 创建时同时加入
refchain(所有对象)和 0 代链表(可能循环引用的对象)。
销毁
引用计数归零时执行 tp_dealloc,流程同 float(先检查 free_list 是否已满)。
5.7 Tuple 类型生命周期
创建
v = (11, 22, 33)// Objects/tupleobject.c
#define PyTuple_MAXSAVESIZE 20
#define PyTuple_MAXFREELIST 2000
static PyTupleObject *free_list[PyTuple_MAXSAVESIZE];
static int numfree[PyTuple_MAXSAVESIZE];
PyObject * PyTuple_New(Py_ssize_t size) {
PyTupleObject *op;
// 空元组:特殊处理,全局唯一
if (size == 0 && free_list[0]) {
op = free_list[0];
Py_INCREF(op);
return (PyObject *) op;
}
// 按元素个数从对应的 free_list 链表获取缓存
if (size < PyTuple_MAXSAVESIZE && (op = free_list[size]) != NULL) {
free_list[size] = (PyTupleObject *) op->ob_item[0];
numfree[size]--;
Py_SIZE(op) = size;
Py_TYPE(op) = &PyTuple_Type;
_Py_NewReference((PyObject *)op);
} else {
op = PyObject_GC_NewVar(PyTupleObject, &PyTuple_Type, size);
if (op == NULL) return NULL;
}
for (int i = 0; i < size; i++)
op->ob_item[i] = NULL;
_PyObject_GC_TRACK(op);
return (PyObject *) op;
}tuple 的 free_list 是按元素个数分组的:
free_list[2]缓存所有 2 元素元组,最多 2000 个。
5.8 Dict 类型生命周期
创建
v = {"name": "武沛齐", "age": 18}// Objects/dictobject.c
#define PyDict_MAXFREELIST 80
static PyDictObject *free_list[PyDict_MAXFREELIST];
static int numfree = 0;
static PyObject * new_dict(PyDictKeysObject *keys, PyObject **values) {
PyDictObject *mp;
if (numfree) {
mp = free_list[--numfree];
_Py_NewReference((PyObject *)mp);
} else {
mp = PyObject_GC_New(PyDictObject, &PyDict_Type);
if (mp == NULL) { ... return NULL; }
}
mp->ma_keys = keys;
mp->ma_values = values;
mp->ma_used = 0;
return (PyObject *)mp;
}销毁
// Objects/dictobject.c
static void dict_dealloc(PyDictObject *mp) {
    PyObject_GC_UnTrack(mp);
    Py_TRASHCAN_BEGIN(mp, dict_dealloc)
    if (numfree < PyDict_MAXFREELIST && Py_TYPE(mp) == &PyDict_Type)
        free_list[numfree++] = mp;  // 缓存
    else
        Py_TYPE(mp)->tp_free((PyObject *)mp);  // 销毁
    Py_TRASHCAN_END
}
6 总结
CPython 垃圾回收机制的三层协作:
                    ┌─────────────────────┐
                    │     引用计数器       │  ← 实时回收(主)
                    │  ob_refcnt == 0 → 销毁│
                    └─────────┬───────────┘
                              │ 循环引用?↓ 无法解决
                    ┌─────────▼───────────┐
                    │  标记清除 + 分代回收  │  ← 定期扫描(辅)
                    │  0/1/2 代阈值触发    │
                    └─────────┬───────────┘
                              │ 销毁前?↓
                    ┌─────────▼───────────┐
                    │     缓存机制         │  ← 提升效率
                    │  free_list / small_ints│
└─────────────────────┘关键要点:
- 引用计数是主力,实时性强,但无法处理循环引用
- 标记清除 + 分代回收专门解决循环引用,按生命周期分级扫描
- 缓存机制避免反复开辟/释放内存,不同类型有不同的缓存策略
- 所有对象都在
refchain链表中,可能存在循环引用的对象额外在分代链表中
相关链接
- Python 面向对象编程 —
__del__方法详解 - Python gc 模块官方文档(访问于 2026-05-22)
- CPython 源码:Objects/floatobject.c(访问于 2026-05-22)